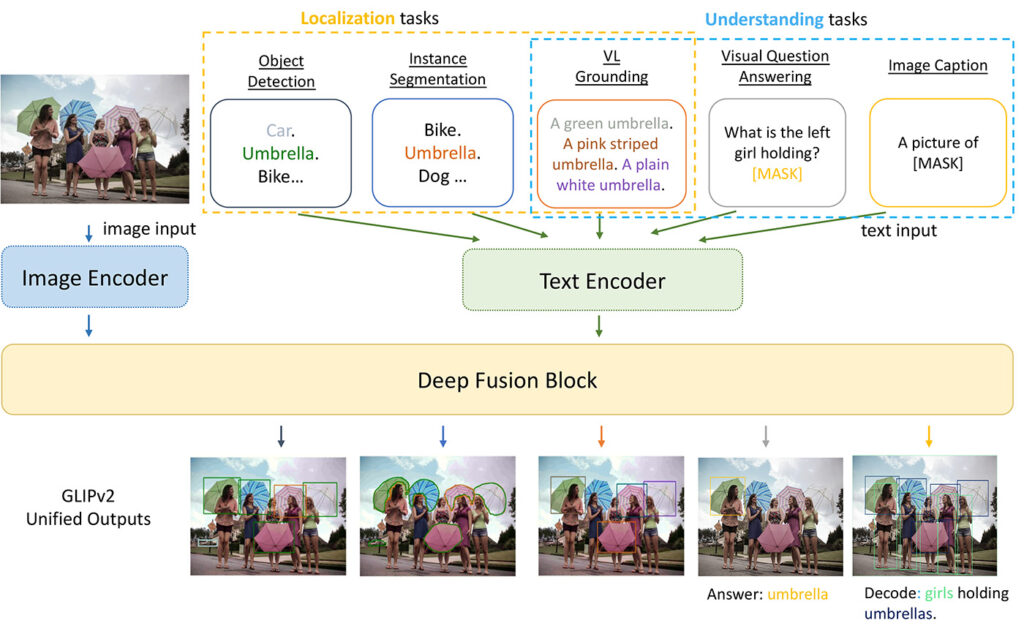
GLIPv2: Unifying Localization and Vision-Language Understanding
One model connects object localization with vision-language tasks, from open-vocabulary detection to visual question answering.
BibTeX citation
@inproceedings{glipv22022,
  title = {GLIPv2: Unifying Localization and Vision-Language Understanding},
  author = {Haotian Zhang and Pengchuan Zhang and Xiaowei Hu and Yen-Chun Chen and Liunian Harold Li and Xiyang Dai and Lijuan Wang and Lu Yuan and Jenq-Neng Hwang and Jianfeng Gao},
  booktitle = {NeurIPS},
  year = {2022},
  url = {https://arxiv.org/abs/2206.05836}
}