GLIP: Grounded Language-Image Pre-training
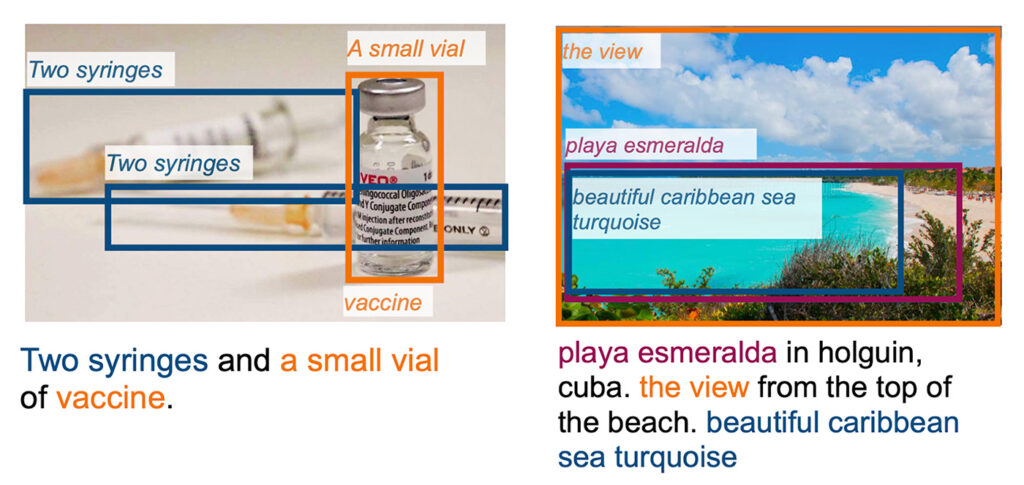
Unifying object detection and phrase grounding enables transferable, open-vocabulary visual recognition.
BibTeX citation
@inproceedings{glip2022,
  title = {GLIP: Grounded Language-Image Pre-training},
  author = {Liunian Harold Li and Pengchuan Zhang and Haotian Zhang and Jianwei Yang and Chunyuan Li and Yiwu Zhong and Lijuan Wang and Lu Yuan and Lei Zhang and Jenq-Neng Hwang and Kai-Wei Chang and Jianfeng Gao},
  booktitle = {CVPR},
  year = {2022},
  url = {https://arxiv.org/abs/2112.03857}
}